
如何使用Python读取.xlsx指定行列
目录
- 引言
- 一、读取工作表内容(.xlsx转化为DataFrame)
- 二、获取指定行指定列数据(DataFrame转化为numpy.ndarray)
- 三、数据处理(numpy.ndarray转化为list/set/dict)
- 参考文章:
- 总结
引言
本文以Python3.9.1读取data.xlsx中包含的西瓜数据集3.0数据为例,数据集如下:
| 编号 | 色泽 | 根蒂 | 敲声 | 纹理 | 脐部 | 触感 | 密度 | 含糖率 | 好瓜 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 青绿 | 蜷缩 | 浊响 | 清晰 | 凹陷 | 硬滑 | 0.697 | 0.46 | 是 |
| 2 | 乌黑 | 蜷缩 | 沉闷 | 清晰 | 凹陷 | 硬滑 | 0.774 | 0.376 | 是 |
| 3 | 乌黑 | 蜷缩 | 浊响 | 清晰 | 凹陷 | 硬滑 | 0.634 | 0.264 | 是 |
| 4 | 青绿 | 蜷缩 | 沉闷 | 清晰 | 凹陷 | 硬滑 | 0.608 | 0.318 | 是 |
| 5 | 浅白 | 蜷缩 | 浊响 | 清晰 | 凹陷 | 硬滑 | 0.556 | 0.215 | 是 |
| 6 | 青绿 | 稍蜷 | 浊响 | 清晰 | 稍凹 | 软粘 | 0.403 | 0.237 | 是 |
| 7 | 乌黑 | 稍蜷 | 浊响 | 稍糊 | 稍凹 | 软粘 | 0.481 | 0.149 | 是 |
| 8 | 乌黑 | 稍蜷 | 浊响 | 清晰 | 稍凹 | 硬滑 | 0.437 | 0.211 | 是 |
| 9 | 乌黑 | 稍蜷 | 沉闷 | 稍糊 | 稍凹 | 硬滑 | 0.666 | 0.091 | 否 |
| 10 | 青绿 | 硬挺 | 清脆 | 清晰 | 平坦 | 软粘 | 0.243 | 0.267 | 否 |
| 11 | 浅白 | 硬挺 | 清脆 | 模糊 | 平坦 | 硬滑 | 0.245 | 0.057 | 否 |
| 12 | 浅白 | 蜷缩 | 浊响 | 模糊 | 平坦 | 软粘 | 0.343 | 0.099 | 否 |
| 13 | 青绿 | 稍蜷 | 浊响 | 稍糊 | 凹陷 | 硬滑 | 0.639 | 0.161 | 否 |
| 14 | 浅白 | 稍蜷 | 沉闷 | 稍糊 | 凹陷 | 硬滑 | 0.657 | 0.198 | 否 |
| 15 | 乌黑 | 稍蜷 | 浊响 | 清晰 | 稍凹 | 软粘 | 0.36 | 0.37 | 否 |
| 16 | 浅白 | 蜷缩 | 浊响 | 模糊 | 平坦 | 硬滑 | 0.593 | 0.042 | 否 |
| 17 | 青绿 | 蜷缩 | 沉闷 | 稍糊 | 稍凹 | 硬滑 | 0.719 | 0.103 | 否 |
代码段:
一、读取工作表内容(.xlsx转化为DataFrame)
导入pandas库,读取工作表数据
import pandas as pd
df = pd.read_excel(r'E:\Aownplan\data.xlsx')#默认读取工作簿中第一个工作表,默认第一行为表头
备注:r是为了读取文件路径中\字符,防止转义。
此处利用pandas库的 read_excel 函数读取文件,获取到的函数返回值类型为DataFrame,后续所有的操作均是基于DataFrame的数据操作方法进行。
二、获取指定行指定列数据(DataFrame转化为numpy.ndarray)
获取整个工作表数据
data=df.values#获取整个工作表数据
print("读取整个工作表的数据:\n{0}".format(data))
获取某一行数据
data=df.iloc[0].values#0表示第一行,不包含表头
print("读取指定行的数据:\n{0}".format(data))
获取多行数据
data=df.head().values#head()默认读取前5行数据(不包含表头)
print("获取工作表前5行数据:\n{0}".format(data))

data=df.iloc[[1,2]].values#读取指定多行,在iloc[]里面嵌套列表指定行数
print("读取指定多行的数据:\n{0}".format(data))

data=df.sample(3).values#读取df中随机3行数据(3个样本)
print("获取随机多行数据:\n{0}".format(data))
获取指定单元格数据
data=df.iloc[1,2]#读取索引为[1, 2]的值,这里不需要嵌套列表
print("读取指定某行某列(单元格)的数据:\n{0}".format(data))
获取指定列数据
print("输出值\n",df['含糖率'].values)
获取指定多列数据
data=df.loc[:,['敲声','纹理']].values#读所有行的敲声以及纹理列的值,这里需要嵌套列表
print("读取指定列的数据:\n{0}".format(data))
获取指定多行多列数据
data=df.loc[[1,2],['密度','含糖率']].values#读取第一行第二行的密度以及含糖率列的值,这里需要嵌套列表
print("读取指定多行多列的数据:\n{0}".format(data))
获取行号和列标题
print("输出行号列表",df.index.values)
print("输出列标题",df.columns.values)
三、数据处理(numpy.ndarray转化为list/set/dict)
(1) 转化为列表list
以上通过.values方法获取到的data值,均为二维值数组(numpy.ndarray)类型,在使用时如果需要转换为列表类型,可使用.tolist()方法,如:
data=df.values.tolist()
此时的输出为:
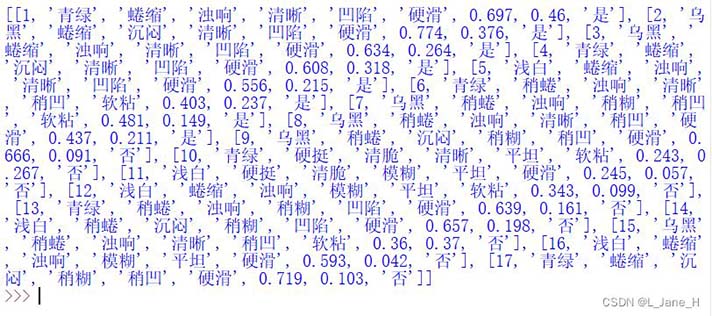
此时的data为list类型,其中每一行数据均为一个列表,多个列表合并为一个二维列表,此时要获取指定行(m)的数据,使用 data[m],获取指定单元格数据,使用data[m][n]。
(2) 转化为集合set
在分析时,若想获取某一列的数据集合,则可以先提取该列数据,然后使用set()函数将其转化为集合即可,如当前为获取敲声的类型,进行如下操作:
data=df['敲声'].values
print(set(data))
此时的输出:
{'清脆', '浊响', '沉闷'}
获取除编号,密度,含糖率外所有列的集合:
titles = df.columns.values
for title in titles:
    if title != '编号' and title != '密度' and title != '含糖率':
        key = df[title].values
        values = set(key)
        print(title,':',values)
输出:
色泽 : {'乌黑', '青绿', '浅白'}
根蒂 : {'蜷缩', '稍蜷', '硬挺'}
敲声 : {'清脆', '浊响', '沉闷'}
纹理 : {'清晰', '稍糊', '模糊'}
脐部 : {'平坦', '稍凹', '凹陷'}
触感 : {'硬滑', '软粘'}
好瓜 : {'是', '否'}
(3) 转化为字典dict
如果需要读取某一行的数据为字典,可进行如下操作:
data=df.iloc[0].values#获取某行数据
title=df.columns.values#获取列标题
a=zip(title,data)#将其压缩为一个元组
print(dict(a))#转化为字典
输出:
{'编号': 1, '色泽': '青绿', '根蒂': '蜷缩', '敲声': '浊响', '纹理': '清晰', '脐部': '凹陷', '触感': '硬滑', '密度': 0.697,'含糖率': 0.46, '好瓜': '是'}
获取除编号,密度,含糖率外所有列的字典:
titles = df.columns.values
adict=dict()
for title in titles:
    if title != '编号' and title != '密度' and title != '含糖率':
        key = df[title].values
        adict[title]=set(key)
print(adict)
输出:
{'色泽': {'乌黑', '青绿', '浅白'}, '根蒂': {'蜷缩', '稍蜷', '硬挺'}, '敲声': {'清脆', '浊响', '沉闷'}, '纹理': {'清晰', '稍糊', '模糊'}, '脐部': {'平坦', '稍凹', '凹陷'}, '触感': {'硬滑', '软粘'}, '好瓜': {'是', '否'}}
参考文章:
[1]. Python利用pandas处理Excel数据的应用
总结
到此这篇关于如何使用Python读取.xlsx指定行列的文章就介绍到这了,更多相关Python读取.xlsx指定行列内容请搜索我们以前的文章或继续浏览下面的相关文章希望大家以后多多支持我们!
相关推荐
-
Python读取xlsx文件的实现方法
脚本如下: from openpyxl import load_workbook workbook = load_workbook(u'/tmp/test.xlsx') #找到需要xlsx文件的位置 booksheet = workbook.active #获取当前活跃的sheet,默认是第一个sheet #如果想获取别的sheet页采取下面这种方式,先获取所有sheet页名,在通过指定那一页. # sheets = workbook.get_sheet_names() # 从名称获取sheet
-

用python读取xlsx文件
一 准备工作: 二 xlrd库读取 首先安装xlrd库,安装方法: pip install xlrd import xlrd #打开excel wb = xlrd.open_workbook('test_user_data.xlsx') #按工作簿定位工作表 sh = wb.sheet_by_name('TestUserLogin') print(sh.nrows)#有效数据行数 print(sh.ncols)#有效数据列数 print(sh.cell(0,0).value)#输出第一行第一列的
-
Python读取xlsx数据生成图标代码实例
运行结果: 程序代码如下: #将excel中的数据进行读取分析 import openpyxl import numpy as np import math import matplotlib.pyplot as pit wk=openpyxl.load_workbook('信息11.xlsx') sheet=wk.active rows=sheet.max_row cols=sheet.max_column lst1=[] lst2=[] for i in range (1,rows+1):
-
python操作xlsx格式文件并读取
之前给大家介绍过python高手之路python处理excel文件(方法汇总) Python操作Excel之xlsx文件 今天继续围绕python xlsx格式文件的操作方法给大家介绍,具体内容如下: 一.准备工作 二 .xlrd库读取 首先安装xlrd库,安装方法:pip install xlrd import xlrd #打开excel wb = xlrd.open_workbook('test_user_data.xlsx') #按工作簿定位工作表 sh = wb.sheet_by_na
-
python使用xlrd模块读取xlsx文件中的ip方法
程序中经常需要使用excel文件,批量读取文件中的数据 python读取excel文件可以使用xlrd模块 pip install xlrd安装模块 示例: #coding=utf8 import xlrd from os import path import sys filename='ip.xlsx' if not path.isfile(filename): print "err: not exists or not file ip.xlsx " sys.exit() getfi
-
Python读取xlsx文件报错:xlrd.biffh.XLRDError: Excel xlsx file;not supported问题解决
目录 发现错误 (1)检查第三方库xlrd的版本: (2)别忘了修改import名称与调用的包名称 总结 发现错误 利用Python库xlrd中的xlrd.open_workbook()函数读取自定义xlsx表格文件时出错如下: Traceback (most recent call last): File "C:/Users/llll/PycharmProjects/pythonProject1/RandomForestRegression.py", line 96, in <
-
python3读取csv和xlsx文件的实例
基于win10系统,python3.6 读取csv 使用csv函数包,安装 pip install csv 使用方法: import csv def fileload(filename = '待读取.csv'): csvfile = open(filename, encoding = 'utf-8') data = csv.reader(csvfile) dataset = [] for line in data: dataset.append(line) csvfile.close() ret
-
python读取xlsx的方法
如下所示: import xlrd data = xlrd.open_workbook('path') # 第1个sheet table = data.sheet()[0] # 获取行数 nrows = tables.nrows for i in range(nrows): if i == 0: continue # 第i行第j列 print(str(table.row_values(i)[j]).strip()) 以上这篇python读取xl
-
用python实现读取xlsx表格操作
目录 前言 读操作 总结 前言 快要过年了,现在是工作的事情也不想干,学习也完全学不进去,关于xlsx的操作原本昨天已经写好了,不过悲催的是,忘记发布了直接关浏览器关闭后发现已经丢失了.以下操作均对照改表格操作: 读操作 获取sheet的方法通过索引获取sheet表格: table = worbook.sheets()[0] table = worbook.sheet_by_index(0) 通过sheet名称获取: table = worbook.sheet_by_name(sheet_nam
-
如何使用Python读取.xlsx指定行列
目录 引言 一.读取工作表内容(.xlsx转化为DataFrame) 二.获取指定行指定列数据(DataFrame转化为numpy.ndarray) 三.数据处理(numpy.ndarray转化为list/set/dict) 参考文章: 总结 引言 本文以Python3.9.1读取data.xlsx中包含的西瓜数据集3.0数据为例,数据集如下: 编号 色泽 根蒂 敲声 纹理 脐部 触感 密度 含糖率 好瓜 1 青绿 蜷缩 浊响 清晰 凹陷 硬滑 0.697 0.46 是 2 乌黑 蜷缩 沉闷 清
-
python读取excel指定列数据并写入到新的excel方法
如下所示: #encoding=utf-8 import xlrd from xlwt import * #------------------读数据--------------------------------- fileName="C:\\Users\\st\\Desktop\\test\\20170221131701.xlsx" bk=xlrd.open_workbook(fileName) shxrange=range(bk.nsheets) try: sh=bk.sheet
-
Python读取excel指定列生成指定sql脚本的方法
需求 最近公司干活,收到一个需求,说是让手动将数据库查出来的信息复制粘贴到excel中,在用excel中写好的公式将指定的两列数据用update这样的语句替换掉. 例如: 有个A库,其中有两个A.01和A.02字段,需要将这两个字段替换到下面的sql语句中, update A set A.01 = 'excel第一列的值' where A.02 = 'excel第二列的值' 虽然excel中公式写好了,但是还需要将总计的那行复制粘贴到txt文档中,所以索性太麻烦,果断用Python写了一个自动化
-
python读取文件指定行内容实例讲解
python读取文件指定行内容 import linecache text=linecache.getline(r'C:\Users\Administrator\Desktop\SourceCodeofMongoRedis\chapter_5\generate_string.py',10) 第十行内容为# info = '''1000001 王小小''' 实例扩展: 本文实例讲述了Python3实现从文件中读取指定行的方法.分享给大家供大家参考.具体实现方法如下: ''' 遇到问题没人解答?小编